昨今の生成AIの進歩が留まることを知らない勢いであることは論を俟たないかと思いますし、かく言う僕もAIエージェントの進歩が十分なレベルに達したのを見て、コーディングからドキュメント類の作成から果ては日常業務のマネジメントに至るまで、今や何でもAIエージェントに丸投げしているという有様だったりします。
ただ、「日常業務のマネジメント」や「分散して保存されているデータをかき集めての大規模メタアナリシス」みたいな、コーディングなどとはまた異なるデータソース探索やルール制約などの複雑性を伴うタスクをAIエージェントにやらせていると、思ったよりも変なハルシネーションに引っ掛かることがあるもので、そこの確度の担保のためにひと手間もふた手間も掛けさせられる羽目になる*1のが、個人的にはまだるっこしいなと感じています。
そんな「複雑なルール推論」に関するAIエージェントの性能を測るためのベンチマークが提案されているのを先日見かけました。それがこちらの論文です。
ということで、早速読んでみて記事にまとめてみようと思います。なおいつもながらですが、かなりの部分をGemini Notebookに丸投げして読み解いていますので、何かしらの問題点などありましたらご指摘くだされば幸いです。
- 世の中には複雑なルール推論を伴うタスクは数多い
- RuleTrek: 6つの異なるドメインをまたいで3要素に分かれるルール推論能力を評価する新たなベンチマーク
- 多くのフロンティア基盤モデルがRuleTrekのスコアに大幅な改善の余地を残した
- コメントなど
世の中には複雑なルール推論を伴うタスクは数多い
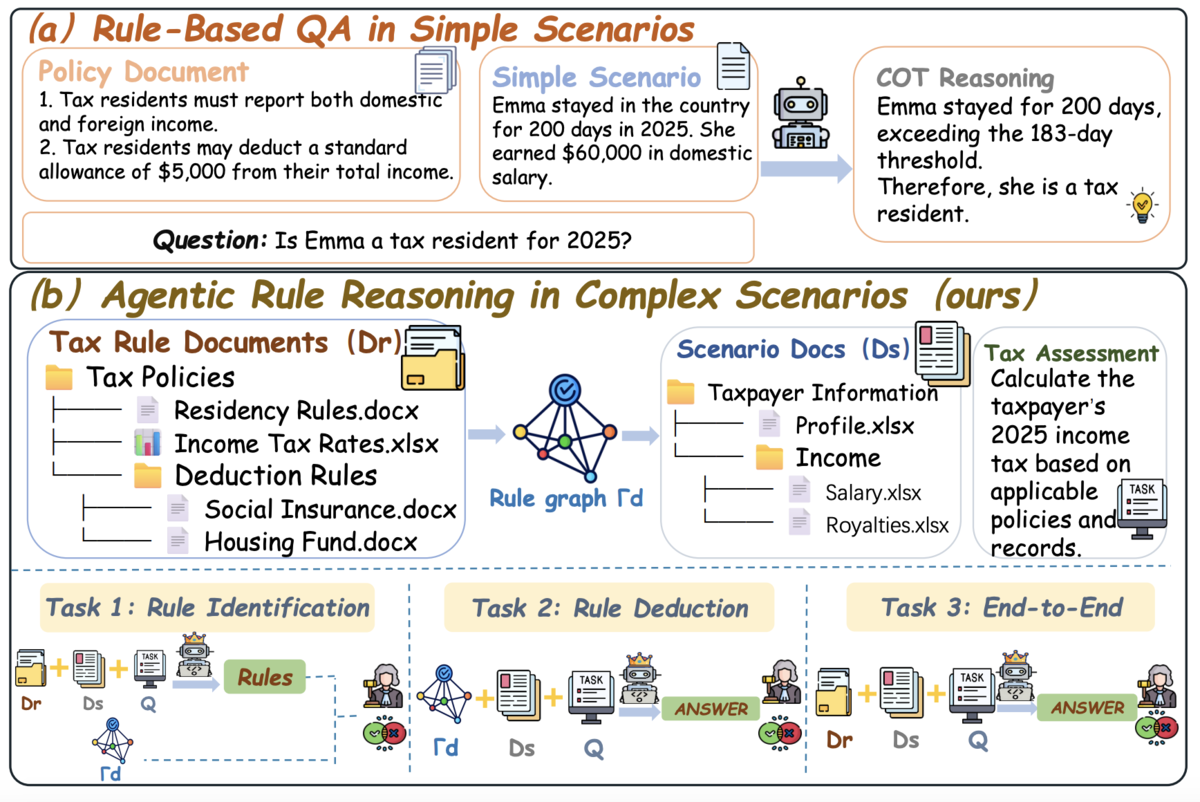
Figure 1でイラスト化して解説されていますが、世の中には複雑なルール推論を伴うタスクが数多く存在します。例えば、「納税」は納税者自身の基礎情報・給与の情報・有価証券など金融取引による収入の情報といった別々のデータソースに基づいて、さらに所得税・ストックオプション課税・各種控除といった別々のルールを統合して適用し、最終的な税額を計算することで実現される、複雑なタスクです。
しかし、こういった複雑なタスクにも生成AIが広く使われるようになった一方で、まだまだ対応し切れずトラブルになるケースも少なくないのが現状です。その理由の一つとして、「ドメイン固有のルールを識別して適用する」能力が発展途上であることが挙げられているそうで、近年提案されている様々なベンチマークでは主に「分散された情報を取得する能力」「ツールを適用する能力」「複数ステップのタスクを完了させる能力」などを評価できるようにしてきたそうです。それらに対し、この論文では肝心の「複雑なシナリオ下における課題を解決するためにドメイン固有のルールを特定して演繹的に適用する能力」そのものを評価できるベンチマークが未だほとんど無いと指摘します。
そこで、「複雑なシナリオでルールに基づいて演繹的に推論するAIエージェントの能力を評価するためのマルチドメインベンチマーク」をこの論文は提案しています。それが、以下に紹介するRuleTrekです。
RuleTrek: 6つの異なるドメインをまたいで3要素に分かれるルール推論能力を評価する新たなベンチマーク
ここからRuleTrekについて解説していきますが、簡単のためかなり大雑把な説明に留めてあります。よって正確な内容については必ず論文本文をお読みください。
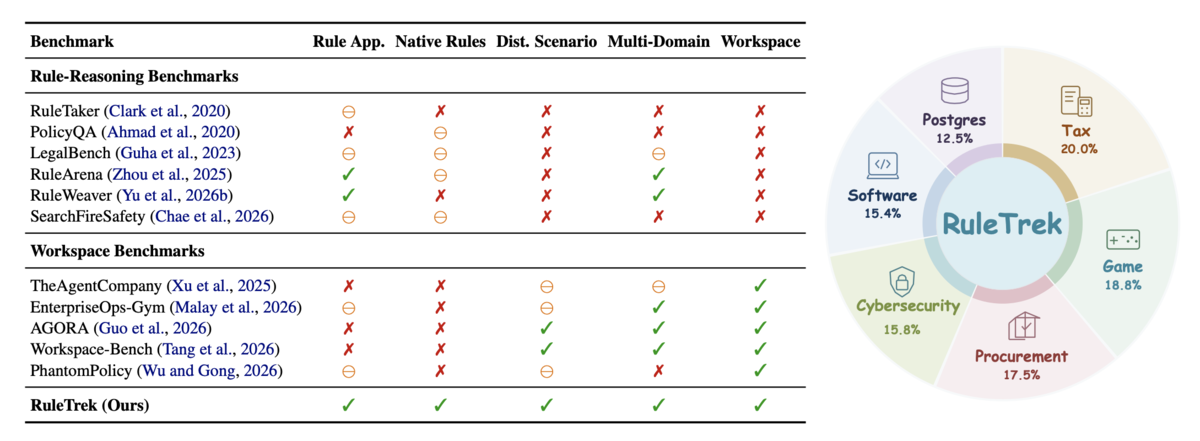
まず、Figure 2に既存ベンチマークとRuleTrekとの対比がまとめられていますが、本論文を読む上ではそこまで重要な気がしないのでこの記事では割愛します(詳細は論文本文を参照されたし)。RuleTrekがカバーするドメインとしては課税・PostgreSQL・サイバーセキュリティ・ソフトウェアポリシー・調達・ゲームの6領域が選ばれており、分散して設定された複数の情報源*2に対してドメイン特化ではない汎化されたルール推論を行う能力を評価できるようになっています。
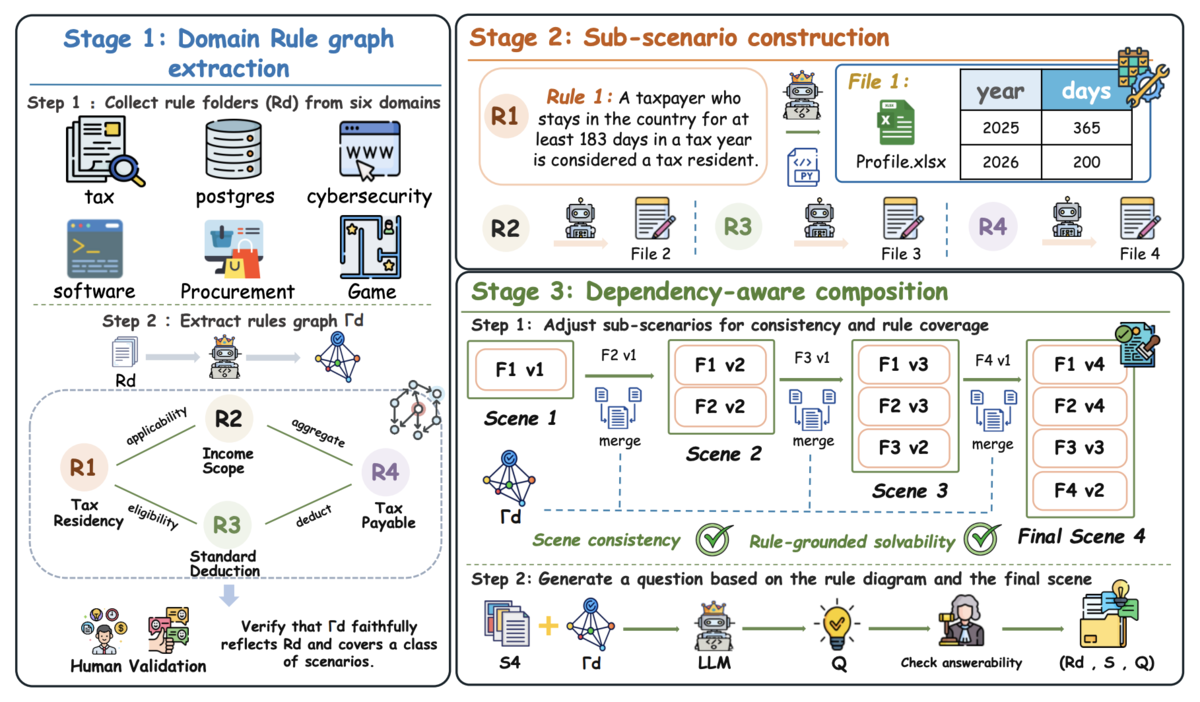
一方で、Figure 3にはRuleTrekの詳細がまとめられています。AIエージェントの「複雑なルール推論」に関する能力を既存ベンチマークよりもさらに的確に評価するために、この論文ではその能力を以下の3要素(Figure 1下段参照)に分けて評価するものと定めています。
1つ目は「ルール識別」(Rule Identification: RI)。これはAIエージェントが与えられたルール文書から適切なルールとその依存関係を識別する能力を評価するものです。正解というか模範回答はヒトの専門家がチェックした上でGPT-6-Astraで抽出した、構造化ルールグラフとして与えられたもので、これを正しく答えられるかどうかで測ります(故に課題の最終回答は要求されない)。つまり、純粋に「ルールを把握する能力」を測ろうということですね。
2つ目は「ルール演繹」(Rule Deduction: RD)。これはAIエージェントが分散されたシナリオ情報を統合し、その上で与えられた必要なルールに正しく従って複雑なシナリオを演繹的に推論する能力を評価するものです。課題としては、グラフ内の各ルールを事前に与えた上で、そのルールを適用しなければ解けないサブシナリオをAIエージェントに解かせるというもので、言い換えると「ルールに従って演繹的に推論する」という、かつて生成AIが不得手だとされた課題を解く能力(詳細は後述)を測るものです。
3つ目は「エンドツーエンドルール推論」(End-to-End Rule Reasoning: E2E)。これはもう読んで字の如しで、先述のRIとRDを組み合わせて、実際に複雑なルール推論を要求されるシナリオ下において複雑なタスクを一貫してAIエージェントに解かせて、最終的な回答を出力させるというものです。
RuleTrek全体では、6分野で合計して240個の評価インスタンス*3が用意され、それぞれノード数・エッジ数・グラフの深さがバラバラな構造化ルールグラフを持つように課題が作られたとのこと。これらを各種フロンティア基盤モデルを中心とするLLMたちに解かせてそのパフォーマンスを評価するわけですが、面白いのがその採点方法。ヒトが全てやるのは汎用性に乏しくスケーラビリティがないので、評価ジャッジには定型のプロンプトを用意した上でGPT-5.6-Lunaを使い、その採点結果がヒトによる採点結果とほぼ一致することを確認して*4、その信頼性を担保させるようにしています。
多くのフロンティア基盤モデルがRuleTrekのスコアに大幅な改善の余地を残した
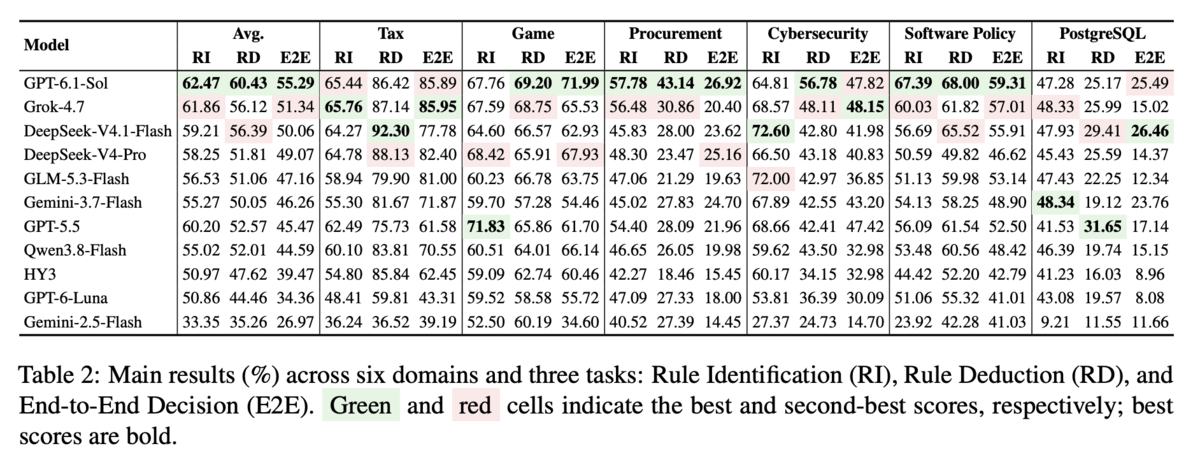
以上の通り構築されたRuleTrekベンチマークに対する、主要な11個のフロンティア基盤モデルのパフォーマンスをまとめたのがTable 2です。その結果は、個々のモデルの優劣を表すだけでなく、ルール(演繹)推論という課題に対する現行の生成AIが抱える問題の本質を示唆しているように見えます。
目を引くのが「RIとRDの難しさ」。まずRIについては、最上位モデルのGPT-6.1-SolでもRIの正答率は62.47%に留まっています。そして多くのモデルが一般的な要件は捉えられていても、細分化されたアクセス制御条件やデータの初期化ルール、ゲームにおけるプレイヤーの移動速度ごとに設定された移動ルールなどの「個々の条件ごとに定められた固有のルール」を見落としたり混同したりしていると指摘されています。
次にRDについて。こちらも、事前に正しいルールグラフを与えているにもかかわらず、最高スコアは60.43%に留まりました。生成AIにとっては、たとえルールが分かっていたとしても、多くのファイルに分散した情報を互いに紐付け、計算・推論を演繹的に正確に行うこと自体がまだまだ困難だという現実を示しているとされています。
E2Eについても注目すべき知見があります。それは「ルールグラフの深さとの相関」。ある意味当たり前の結果かもしれませんが、ルールグラフの「ノード数(ルール数)」および「深さ(依存関係の長さ)」とE2E性能の間には明確な逆相関が見られたとのことです。
さらに、RD正答率とE2E正答率を比較すると、すべてのモデルでRDがE2Eを3.79〜8.15%上回っています。これは、元の文書からのルール特定作業が確実に追加の負荷(ボトルネック)になっていることを意味するとされています。
そして、試行ステップ数(環境とのインタラクション回数)の多さは、必ずしも精度の高さに直結しないということも論文中で指摘されています。これはフロンティア基盤モデルごとの「癖」があるようで、例えばGPT-6.1-Solは少ないステップ数でルールを特定して正解に辿り着いたものの、Qwen3.8-Flashは同じルールを特定したにもかかわらず別のエラーを蓄積して多くのステップ数を費やした挙句不正解に終わった、というケースが紹介されています。
ということで、本論文ではRuleTrekを新たなベンチマークとして提案した上で、「最先端のLLMであってもルール識別の誤認や複雑な依存関係における推論エラーが多発し、人間の業務代替には至っていない現実が浮き彫りとなった」結論付けています。ただし、「与えたデータは全て英語に限定した」点と「静的な環境に限定した(動的にルールや情報が変化していくことは考慮外)」点を制約事項として挙げており、今後の課題だとしています。
コメントなど
昨年バズった記事で「生成AIは演繹的推論が苦手」という議論をしたんですが、その後フロンティア基盤モデルを初めとしてエージェント化が飛躍的に進み、巷でも性能向上が著しいとの評が多く聞かれるようになり、「なるほどAIエージェントへと進化したことで演繹的推論の問題はクリアされたんだな」と、僕個人は納得したつもりになっていたのでした。
その意味では、今回紹介したRuleTrek論文はそんな楽観的な僕の見方に真っ正面から冷や水をぶっ掛けるものだと言っても過言ではないと思っています。最も優秀なスコアを叩き出したGPT-6.1-SolでもE2Eの平均正答率が55%程度だった*5ということを考えると、冒頭に触れた「思ったよりも変なところでハルシネーションを起こしてタスクを完遂し損ねることが少なくない」という僕の感想は、存外に実態を外していないということなのでしょう。
勿論、このRuleTrekが生成AI開発における金科玉条として位置付けられるようになるかというと疑問の余地がありますし、況してやこれをベンチマークとした開発が広く行われるようになるかというとそんなことは無いだろうと思います。とは言え、個人的には「ルール演繹推論」がある程度以上出来ることをベンチマークで担保するような、AIエージェント開発がもっと広く行われてほしいなぁと願う次第です。単に僕個人がそういうタイプのハルシネーションにしょっちゅう悩まされているから、というだけなのですが(笑)。
